

400-820-8531
 图1. 针对质谱的淀粉酶质组学评述(图源:Shuken, J Proteome Res, 2023)
01.信息分折:多肽鉴定会
一次LC-MS/MS作业制造的原本资料分析集是一种个大的光谱分析分析碰面,每次光谱分析分析都可以保存的时间、m/z值、硬度和元资料分析。进行MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等pc软件包净化处理那些资料分析,产生肽和/或淀粉酶质详细信息,每次识别图片都可以一款 结果。基本上数非靶向治疗的自下而上的DDA淀粉酶质组学进行实验中选用的常用见的肽鉴别方法步骤为资料分析库关注(图2)。
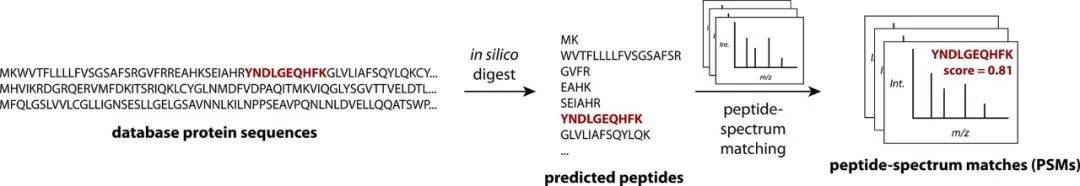 图2. 信息库搜到的抽象化发展历程(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的酪氨酸编码序列(图源:Shuken, J Proteome Res, 2023)
 图4. 场面m/z值、带注解的MS2谱,并且图3中体现屏幕上显示的场面字段(NILIDFTK)
1.1 数据资料库收索梯度下降法范例:SEQUEST的要学会简化简述
SEQUEST是1991年出版发行的首只全系统自动肽识別手机软件。图5亲身演示了SEQUESTjava算法的简单化概念呢。先,对选取球营养物质组预估的肽开始脱水,方能只考虑一下与提取的裂开阴阳正离子的m/z值类同的前体(即电势阶段特异形肽阴阳正离子),如果制成说法光谱图分析图分析图分析仪分析图仪仪(图5,上端)。依据将科学试验光谱图分析图分析图分析仪分析图仪仪与预估精彩场面描写的m/z值开始大概是比较,说法光谱图分析图分析图分析仪分析图仪仪被很快脱水,连接精彩场面描写的数量统计、MS2承载力和沒有有关于表现结炼制的考分,仅删去研究背景该考分的前500个说法光谱图分析图分析图分析仪分析图仪仪(图5,方法流程之一1)。依据排除前体峰,将光谱图分析图分析图分析仪分析图仪仪分割为多个之比的行政区域内,并将每一位行政区域内的承载力归一化作一样的的值来更改科学试验光谱图分析图分析图分析仪分析图仪仪(图5,方法流程之一2),这每一步使科学试验光谱图分析图分析图分析仪分析图仪仪更相近说法光谱图分析图分析图分析仪分析图仪仪,下降了创建说法光谱图分析图分析图分析仪分析图仪仪时无视的可变气门正时勾玉化质量的。依据将每一位m/z值处的承载力相乘并将乘积之和,计算出科学试验光谱图分析图分析图分析仪分析图仪仪与每一位说法光谱图分析图分析图分析仪分析图仪仪直接的间接的关系(图5,方法流程之一3)。
 图5. 简易化了原SEQUEST资料库百度搜索聚类算法的方案格式(图源:Shuken, J Proteome Res, 2023)
1.2 肽评定中的FDR管控
咱们如此决策怎样高考成绩线充足的高来数字代表真实度的ID?现阶段 ,最时尚的方式是 Target-decoy搜所(图6)。该整个过程抑制局部变量错误信息信息知道率(FDR),即被展开的PSM错误信息信息的平均的比倒。以便在抑制FDR的互相主要底限地的加测真肽,还可以施用搜所高考成绩线和PSM的各种特征描述的规则化組合(图6)。规则化組合中施用的常数{a, b,…}被调整以主要底限地的加测真肽,平常施用percolator施用的系统借鉴汉明距离。再次调整结束后,各个超越所必需FDR应对域值的任务符合(如,1%)被调取。整个净化统计数据集的FDR被视为“局部变量”FDR。
 图6. Target-decoy收索。PSM=肽谱识别;FDR =报错显示率(图源:Shuken, J Proteome
02.肽段化学发光法
高效化率的液质色谱在一整个执行阶段中 中连续性地将多肽喷雾的角度到质谱仪中。每扫描仪周期性做次,基本上所需3 s或少点,光谱图图仪导致MS1光谱图图;由此,在高效化率的液质气相色谱柱过柱阶段中 中,前体的MS1峰时不时被查看到很多次,这个MS1统计数据点一块造成色谱峰(图7A)。给定某个的肽,其色谱峰的优点,要是的高度或等值线后面 积(AUC),能用于自动测量肽的相较丰度,这被被视为料框记一定量(LFQ),该做法能用于的不同图纸中的总数很。 从而提高了按量重新性、样机通量和/或数据信息详尽性,箭头电化学药品需要于按量一致质谱中的多生态学技术工程样机。在许多办法中,不仅有其他的拉曼光谱图以至于肽或其段落的m/z值其他外,肽被箭头为雷同的原子团群,一并开展电化学本质,如开展时光、电离性和段落策略。在产生箭头办法中,如组织细胞的培养碳水化合物比较稳定拉曼光谱图箭头(SILAC),运用生态学技术工程体统将包含有重拉曼光谱图的碳水化合物箭头整体的核核蛋白酶组。在样机制得现在开始时,将天然的“轻”核核蛋白酶与重核核蛋白酶综合,接下来与MS1光谱图做出是比较(图7B)。在等压法(即产品一样,因其他的标示还具有雷同的总产品)箭头办法中,如结合产品标示(TMT),肽段在消化不好后被箭头,接下来在LC-MS/MS前搭档。大能CID(HCD)为每一家生态学技术工程样机缓解压力其他的统计铁阳离子;借助MS2或MS3检测自动测量统计铁阳离子难度,需要推测出比较丰度(图7C)。作业LFQ,每天作业阐述一些生态学技术工程样表;作业SILAC,每天作业一般 阐述两到四个生态学技术工程样表;作业TMT,一下需要阐述几斤18种其他的生态学技术工程样表。
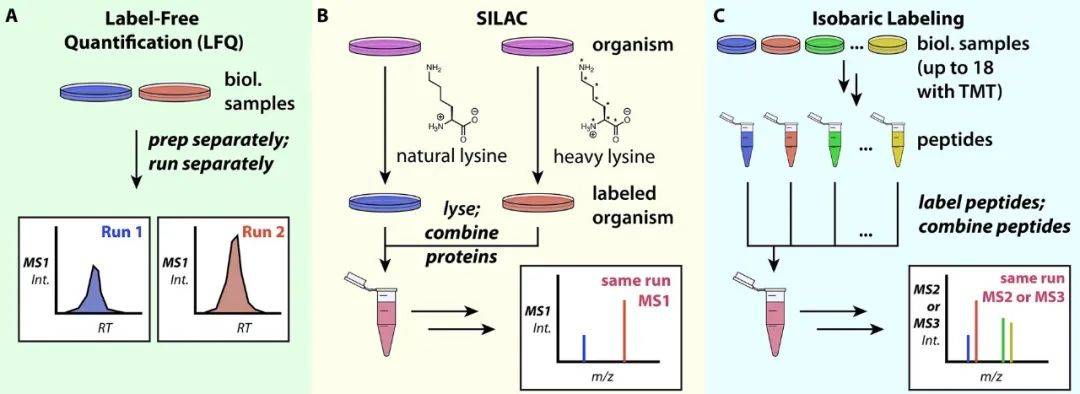 图7. 多肽按量的方式。A.在MS1横向实施料框记按量;B. 細胞陪养中胺基酸稳固放射性同位素记号(SILAC);C. 等压记号
03.“球胆固醇技术”:推测球胆固醇的优点和丰度
3.1 蛋清质判定与排序
我以为那些实用自下而上球胆固醇组学说到了“球胆固醇”的身份证和运行量,但它是往往是鉴别和/或评定球胆固醇群,其源于的球胆固醇或什么是基因几率是不明确责任的。而言各种语病,里常见到的应对设计方案是实用各个PSM对于样机中会有相关球胆固醇的离婚离婚证据。假设多组球胆固醇之前有完全相同的离婚离婚证据(即球胆固醇回文编码序列与同多组鉴别的肽回文编码序列配对,如下图8中的球胆固醇V和VI),则将以下球胆固醇组合成为一名球胆固醇组(PG)。假设一名球胆固醇的配对肽是其他名球胆固醇的子集,则该球胆固醇往往被去掉在计划书本身,而较弱该球胆固醇主要肽但其肽都是子集的球胆固醇是指可包涵球胆固醇。
 图8. 核高蛋白测算和分类政策(图源:Shuken, J Proteome Res, 2023)
3.2 球蛋白程度FDR把控好
太半数以上执行程序蛋清质排列的留行免费软件包,如MaxQuant和Proteome Discoverer,也能否算出蛋清质质量鉴定结论FDR的显著性检验,并将其完后调整到可连受的质量。有好几种步骤能否掌握蛋清质质量的FDR。另外一种直观的策咯是充分利用诱耳PGs,即已经由诱耳PSM成分的PG,二者被自動继承并给予与指标值PSM同一的蛋清质分析判断工作。为每家指标值和诱耳PG搭建一些高考成绩,合法以与PSM FDR类式的具体方法掌握蛋清质质量FDR(图6)。3.3蛋清组酶联免疫法
多肽和核胆固醇之前相互作用的双部分要素使该过程中僵化性化。PG内的肽几率在这句话配备的核胆固醇中真正的爱情有差异 ,这几率会作用这句话的丰度(图8)。要是PG中的肽是该PG所独特的的,她是有鼓励的,支持对单独一款 核胆固醇经由考评。或许,僵化性的是肽几率引发于有效译为后遮盖的核胆固醇,其丰度作用肽的抗拉抗拉强度,还有就是,会因为DDA僵板的随机性性,那些肽几率在一款 原辅料中探究到而在别的款 原辅料中探究不来。风靡的参数资料正确处理appapp包为微信用户作为了解到决这种故障 的工具栏。基本上都数appapp(也包括MaxQuant)只支持对PG-unique肽经由一一定量。那些(如Spectronaut ,Biognosys)支持一些的规格型号,如受限一一定量到核胆固醇特喜欢的人肽,或选会不会操作肽抗拉抗拉强度的中数字、和、数学计算的平总值或多少的平总值来计算PG用户。而对于LFQ,直得注重的是MaxQuant中做到的风靡的MaxLFQ算法为基础。当在有差异 的样品中辨认出有差异 的前体集时,MaxLFQ经由运用可以用的两两有点和操作中数字占比来有点PG来正确处理短缺值。等压标识和参数资料自己收采(DIA)是减低或解除短缺值的所有方案。3.4 统计数探讨和海洋生命科学释疑
假如计算方法出PG的取决于总数,随着研究的生态学学特征,可不行操作各种类型专用工具对然而通过数据统计概述数学了解和表达。Perseus和MSStats是定制便用淀粉酶质组总数加工和数据统计概述数学了解的留行平台包。数据数据统计概述信息也可不行操作程序编程語言(如python或R)手动操作时了解。在通常更淀粉酶质组学研究中,属于从目录中出掉水工业废气或钓鱼诱饵,操作常用对数使总数矩阵合同正态分布图,将数据数据统计概述信息归一化以调整执行间的新技术进化性,操作数据统计概述数学定期检查(如t定期检查/方差了解/线型回到)定期检查变现,并对然而p值通过多选用定期检查。 计算定性探讨结束后,但是也可不能做出微生物制品工程学解说。Gene Ontology是理论研究在检测操作中突发不同的微生物制品工程方式的同一个2017流行一些的信息库。STRING带来了了关与感求知欲的核苷酸质期间相等感情或能够 做用的一些的信息。一些的定性探讨,如加权平均基因组一些的数据电脑网络定性探讨(WGCNA),不同检测操作中核苷酸质丰度不同的形似程度较建设核苷酸质数据电脑网络,这也可不能加强组织领导一个脚印知晓检测操作中核苷酸质期间的感情。确认总合解说这样定性探讨的但是,微生物制品工程学比如也可不能取到帮助或批驳,且也可不能生成新的比如。04.拜谱菌物个人小结:质谱运行流程图
总的看来,非标准件记的自下而上的任务标准流程正确: (1)转移集体/仿真植物、融解癌细胞;用磷酸二氢钾和/或去垢剂使蛋白酶质转性。 (2)用DTT或TCEP等方法步骤提高二加硫物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇放置法或磁珠放置法部份纯化蛋白酶质(些许工作的方案不安全使用有毒的去垢剂如SDS,可跳出这三步)。 (4)用胰淀粉酶酶或LysC女子组合淀粉酶酶消化系统淀粉酶质。 (5)用C18包被的过滤水吸管头离心力分离擦拭/脱盐多肽;用正空离心力分离机等蒸馏高沸点溶剂。 (6)将肽重悬于LC-MS兼容的有机溶剂中,举列0.1%甲酸水稀硫酸;主要采用此类的检测设备办法来LC-MS/MS讲解;在运作结束后搜素原本数据库。 (7)选用好的小手机app包清理最数据文件资料文件,如MaxQuant或Proteome Discoverer,或小手机app包的团体,履行数据文件文件库搜所、FDR控制、比较参考值和胆固醇质判定。 (8)动用程序设计语言英语(如python或R)或平台包(如Perseus或MSStats)施行研究研究。 (9)依照科学试验的海洋物理学基本原理来释疑没想到;这能够使用文件目录或wifi网络级解析资源性(如Gene Ontology、STRING或WGCNA)来铺助。 05科技前沿活动形式
不但DDA开始的非靶向药物疗法自下而上的无标示核氨基酸组,和越多的应用场景质谱的的措施来论述探讨核氨基酸组(图9)。医疗仪器和百度算法均在不断创新的的更新,完正核氨基酸、至上而下和先天质谱法也便用于浅析低繁杂性的模本;核核淀粉酶酶质酶的译员后掩盖甚为至关根本的管控做用都有浩瀚的论述探讨盛世。型式的核氨基酸组学、有机化工核氨基酸组学和亲近标示等措施便用有机化工、酶或热措施来遥测核氨基酸,为论述探讨核氨基酸型式的、有机化工、标记、核氨基酸-配体上下级做用或核氨基酸-核氨基酸上下级做用发展壮大了大批的好机会。对比DDA,的参数独立的录入(DIA)就是的一种越多越受热情接待的录入的措施,最最火的DIA的措施是应用场景SWATH-MS,中间全部MS1条件内内的拥有m/z值在每一扫描软件频次内都富含在泥石中,这很大程度上加快了的参数完正性,不断增加了核氨基酸组学深度.。在靶向药物疗法核氨基酸组学中,的一种某的核氨基酸或四组核氨基酸被成为浅析的阶段计划,其阶段计划是为了保证每一次的的措施正常运行时都能测量到阶段计划核氨基酸(的参数完正性强),最大程度可能地加快快速度和动态图片条件内,和定量分析最精确性和精密铸造度。 针对于大大量的球脂肪酸司法鉴定和降钙素原检测,质谱法是现下最畅销的技巧,在未來,质谱与所有非质谱能力的整合安全使用可越深入地认知整生态学学中的球脂肪酸组。
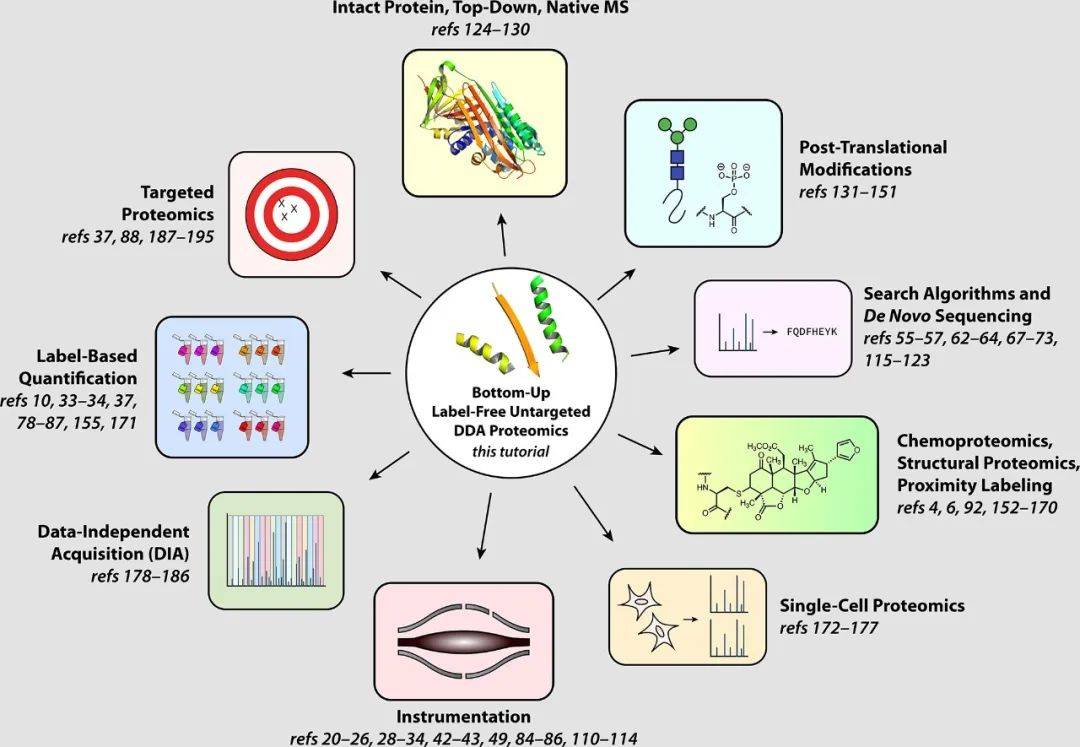 图9. 依据质谱的核蛋白组学的子领域(图源:Shuken, J Proteome Res, 2023)
符合论文:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 喜爱人们号


 观注小丽书


